売上のExcel表を、ChatGPT・Gemini・Claudeに読み込ませて、月ごとの売上合計、売上が多い商品、担当者ごとの合計、前の月との差の4つを出させました。表は架空の印刷会社のもので、明細は79行です。その中に、次のような行を混ぜてあります。
読み込ませたExcel表の一部太字が、表だけでは決められない値(架空の内容)
| 日付 | 商品 | 担当 | 金額 |
|---|---|---|---|
| 8/1 | シール | 山田 | 12,000 |
| 8/6 | 名刺 | 山田 | 約30,000 |
| 8/10 | 封筒 | (空欄) | 5,000 |
| 9/5 | シール | 田中 | 応相談 |
| 9/18 | 封筒 | 山田 | 50,000 |
| 9/18 | 封筒 | 山田 | 50,000 |
| 9/31 | チラシ | 鈴木 | 8,000 |
金額が「応相談」の行、「約30,000」とだけ書かれた行、9月31日という存在しない日付の行、担当者が空欄の行、全く同じ行が2つ。どれも、表だけでは答えが決まりません。
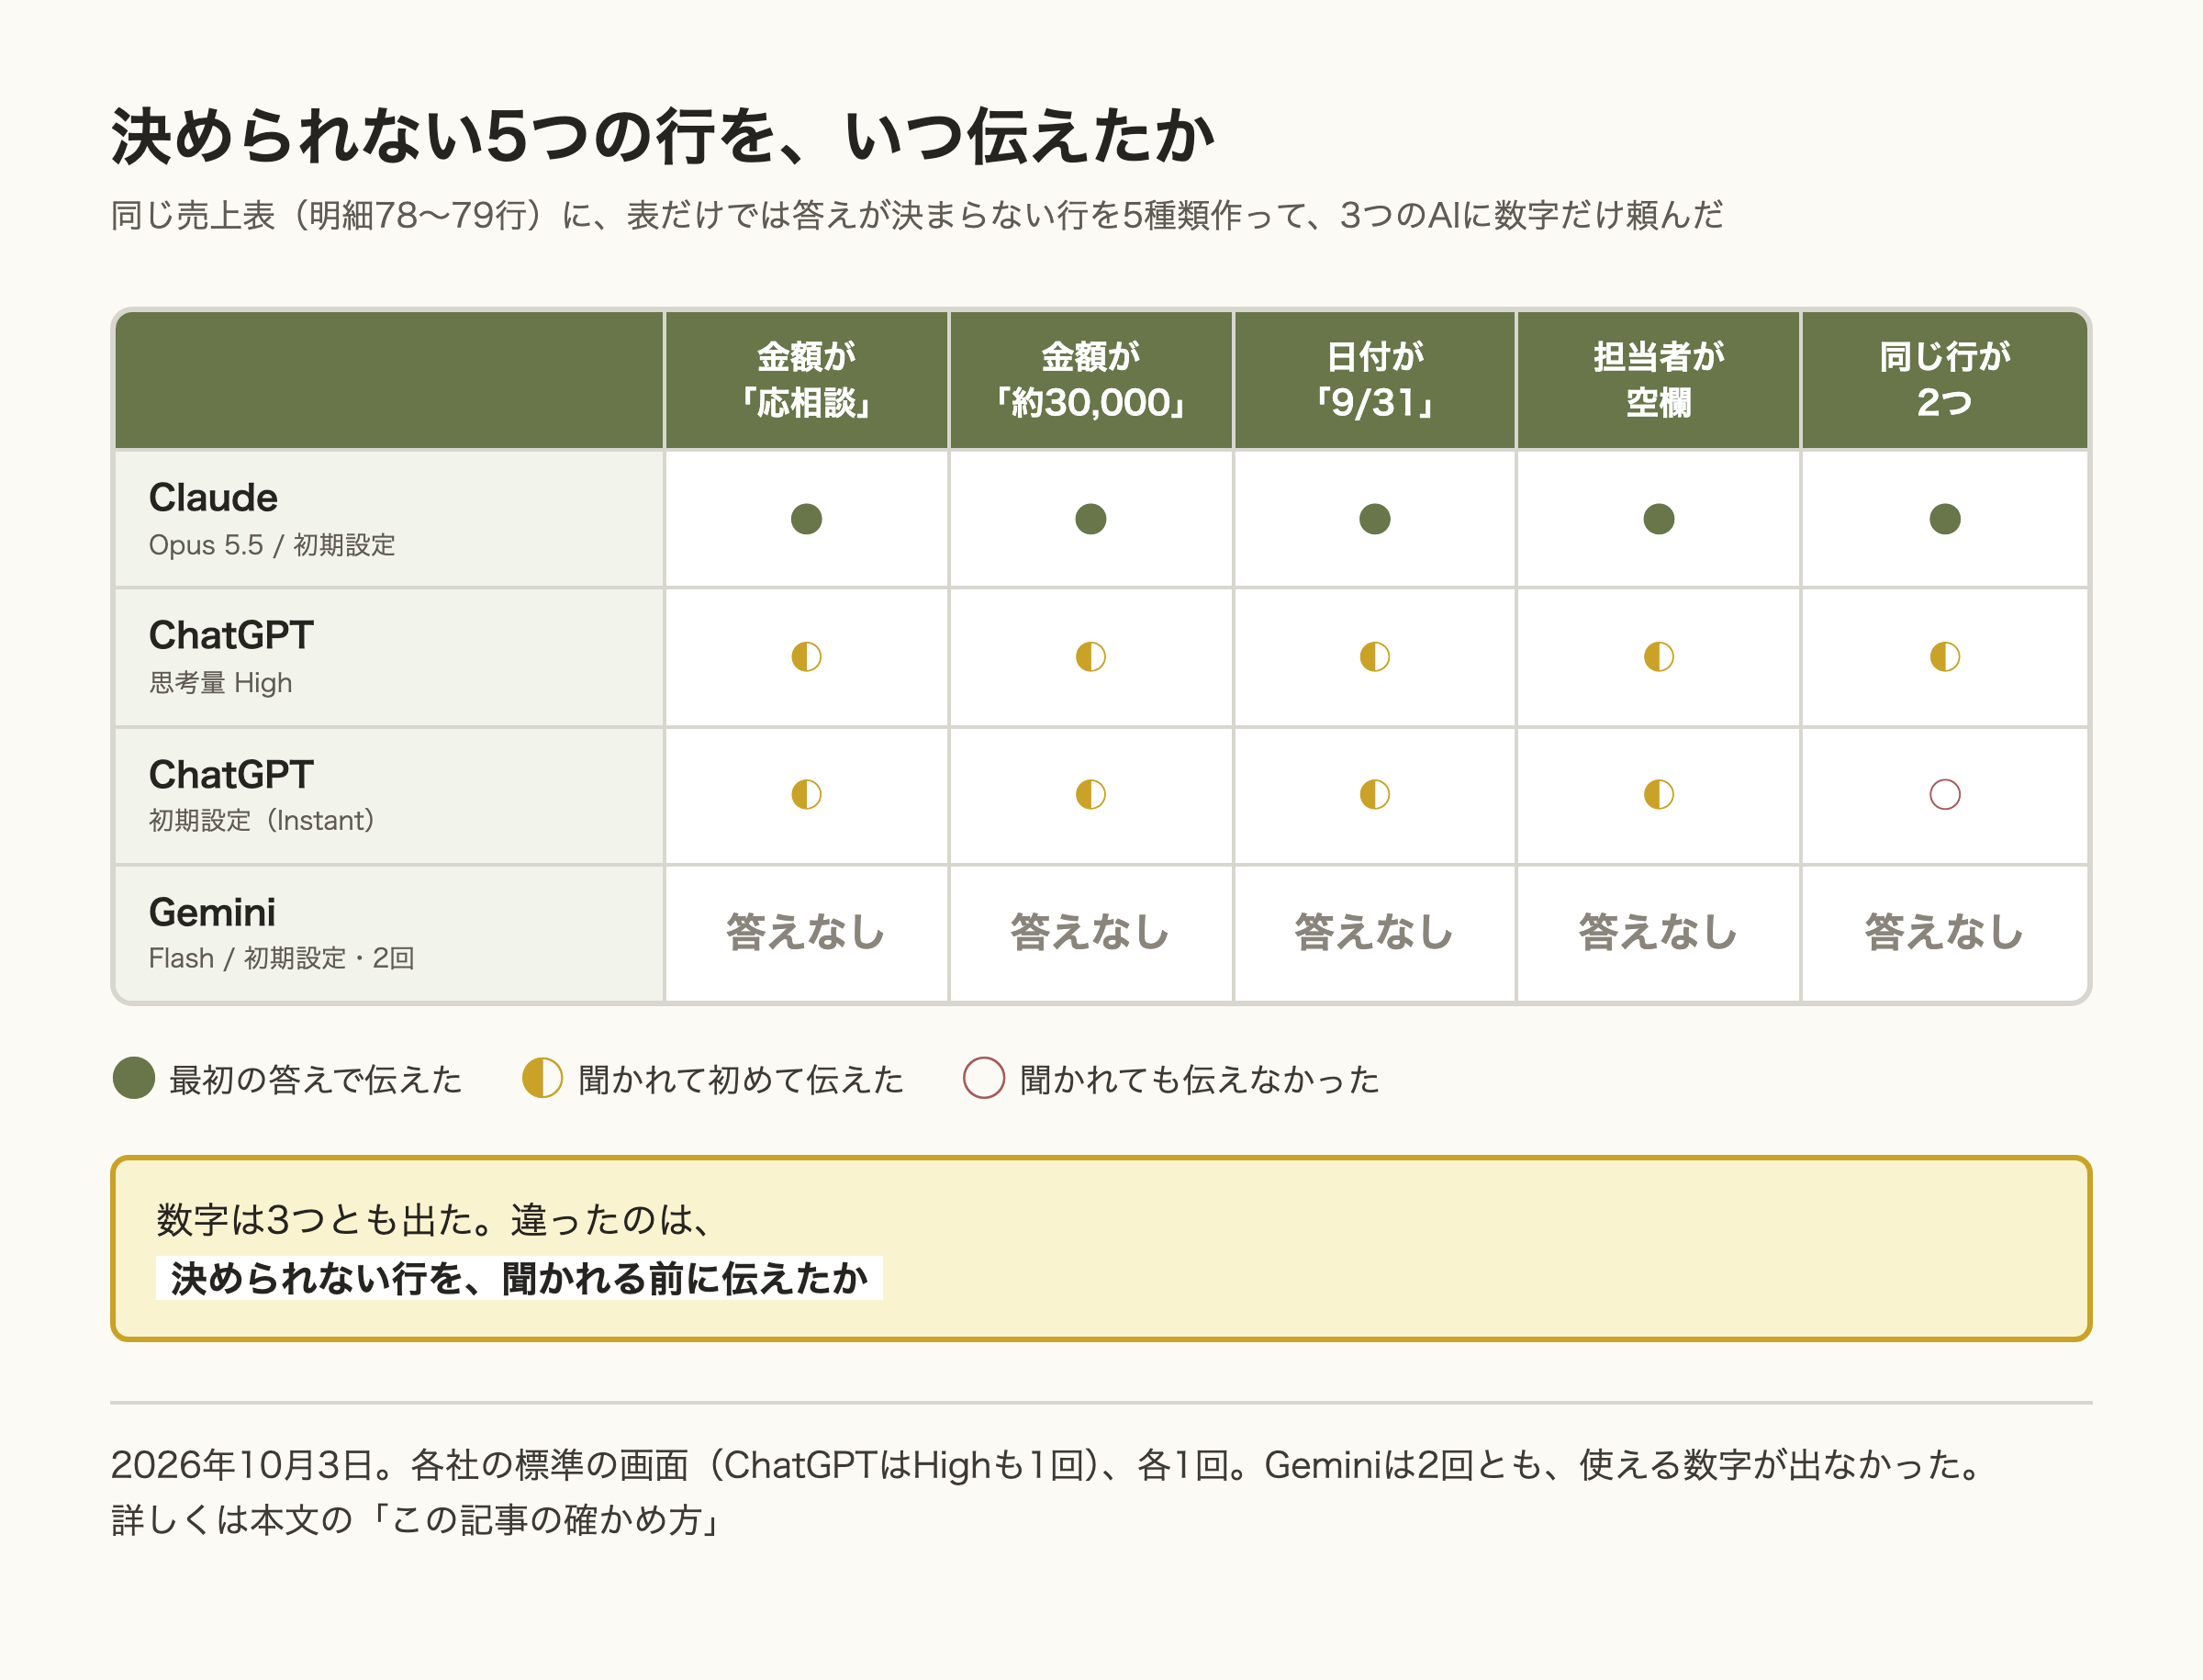
結果は、3つのAIとも数字を出しました。違いが出たのは、この5種類の行を、聞かれる前に伝えたかどうかです。Claudeは、最初の答えで5つとも書きました。ChatGPTは、数字だけを返し、聞かれて初めて説明しました。Geminiは、2回とも使える数字が出ませんでした。
この表を試す前に、文字になった数字や和暦の日付など、ふつうの乱れだけを入れた表も試しています。そちらは、ChatGPTとClaudeが4問とも正解で、Geminiは1回目は答えを出さず、2回目に正解でした。この記事では、その中身と、質問の最後の一文を差し替える方法、集計のあとに見る確認表を紹介します。
同じ売上表を、3つのAIに渡した
画面の操作と記録は、AIが行いました。人が画面を操作したわけではありません。使ったのは、各社のウェブの画面です。Excelの中で動くAI(Copilotなど)は試していません。実際のデータには触れないよう、売上表は架空の印刷会社のものを作りました。8月と9月の売上明細が78行あり、日付、商品、担当者、数量、金額が並んでいます。
質問は4つで、どのAIにも同じ文章を送りました。
4つの質問(そのまま送った文章)
添付のExcelは、2026年8月〜9月の売上明細です。次の4つに答えてください。
1) 8月と9月、それぞれの売上合計
2) 8月に売上が最も多い商品と、その金額
3) 担当者ごとの売上合計(8月〜9月の通算)
4) 9月は8月より何円増えましたか
金額は円で、数字だけ分かるように書いてください。
試験は2回に分けました。1回目は、実際の売上表によくある乱れだけを入れた表です。2回目は、1回目の表の4行を書き換え、1行を足して、答えが決まらない行を5種類作った表です(明細は79行)。使った画面は、ChatGPTは標準の設定(Instant)、Geminiは標準のFlash、ClaudeはOpus 5.5の標準の設定です。ChatGPTだけは、考える量を「High」に上げた設定でも、2回目の表を1回試しました。会社ごとに画面の段が違うので、同じ強さのモデルを並べた比較ではありません。
ふつうの乱れなら、どのAIも直して集計した
1回目の表に入れた乱れは、次のとおりです。どれも、実際の売上表で見かけるものです。
1回目の表に入れたものどれも架空の内容
| 種類 | 中身 |
|---|---|
| 文字になった金額 | 「15,000」のようなカンマ付きが6件、「5000」のような全角数字が4件 |
| 日付の書き方 | 文字の日付が12件。「2026/8/3」型と、令和8年を表す「R8.8.4」型 |
| 商品名のゆれ | 末尾に空白が付いたものと、半角カナの「チラシ」が合わせて10件 |
| 月の小計の行 | 明細の間に「8月小計」「9月小計」の2行(足すと二重になる) |
| 空の行・返品 | 空の行が1行。返品のマイナス行が2行(売上から引くのが正しい) |
正解は、8月が853,000円、9月が924,000円、8月の最多商品はポスターの264,000円、担当者別は佐藤592,000円・鈴木430,000円・田中408,000円・山田347,000円、増えた額は71,000円です。
ChatGPT(標準)は4問とも正解で、Claudeも4問とも正解でした。Geminiは、1回目は「大規模言語モデルとしてまだ学習中で、お手伝いできません」という文章だけが返りました。画面には「コードを表示」の欄があり、裏で表を読んで計算した形跡はありましたが、数字は出ませんでした。新しい会話でやり直した2回目は、4問とも正解でした。
そのあと、ChatGPTとGeminiには「何を直して集計したか」を聞きました。Claudeは、聞く前の最初の答えに書いていました。
直した点の説明1回目の表
| AI | 説明の中身 |
|---|---|
| ChatGPT(標準) | 小計の行、文字の金額、商品名のゆれ、マイナスの行、日付の書き方の5つ。小計の行は「40行目」「83行目」と答えて、実際の行と一致した |
| Claude | 聞く前に、日付、金額、商品名、返品の4つを書いた。「合計がシートの小計と一致した」という確認も付けていた |
| Gemini(Flash) | 主な説明は、小計の行、文字の金額、半角カナの3つ。末尾で、和暦の日付とマイナスの行にも触れた。小計の行は「37行目」「80行目」と答えたが、実際は40行目と83行目。3行分ずれていた。表の読み込みで使う番号とみられ、Excelの行の番号ではなかった |
ふつうの乱れなら、3つとも、直して集計するところまでできていました。ただ、Geminiが答えた行の番号は、そのままExcelで開くと別の行を指します。AIが教えてくれた場所は、自分の目で確かめる前提にしたほうが安全です。
決められない5種類の行を作ると、伝え方が分かれた
2回目は、1回目の表の4行(金額2件、日付1件、担当者1件)を書き換え、全く同じ行を1行足して、表だけでは答えが決まらない行を5種類作りました。月の小計の2行は、そのままにしてあります。小計は計算式ではなく手で入れた数字なので、明細を足した値と合わなくなりました。
作った5つの行どれも架空の内容
| 行 | 中身 | 決められない理由 |
|---|---|---|
| 金額が「応相談」 | 9/5 シール・田中・1個 | 金額が文字で、いくらか分からない |
| 金額が「約30,000」 | 8/6 名刺・山田・10個 | 約と付いていて、正確な額か分からない |
| 日付が「9/31」 | チラシ・鈴木・8,000円 | 9月31日はない。8月か9月か、別の日かも分からない |
| 担当者が空欄 | 8/10 封筒・5,000円 | 誰の売上か分からない |
| 全く同じ行が2つ | 9/18 封筒・山田・10個・50,000円 | 二重に入力したのか、本当に2件あったのか分からない |
この表に、1回目と同じ4つの質問を、「数字だけ」の一文もそのままに送りました。次の図は、5つの行を、どのAIが、いつ伝えたかをまとめたものです。
ChatGPT:数字だけを返し、聞かれて説明した
ChatGPT(標準)は、数字だけを返しました。9月は970,000円、増えた額は117,000円で、注意書きは1行もありません。「表の中に、そのまま足すと間違えてしまう箇所や、表だけでは決められない箇所はありましたか」と聞くと、応相談、約30,000、9/31、担当者の空欄の4つを説明しました。全く同じ行が2つあることには、触れませんでした。
もう1つ起きたのは、自分の答えを取り消したことです。ChatGPTは、表にある「9月小計 924,000円」を理由に、さきほどの970,000円を「私の集計ミス」と説明しました。ただ、この小計は手で入れた数字です。応相談を0円、9/31を9月、全く同じ2行を2件と読めば、明細は970,000円になり、この読み方は誤りとは言えません。小計のほうが古い可能性もあります。
考える量を「High」にすると、答えは924,000円、増えた額は71,000円で、これも注意書きなしでした。聞くと、5つの行をすべて説明し、こう書きました。応相談は他のシールが1個4,000円なので4,000円と置いた、全く同じ2行は1件として数えた、そうすると小計の924,000円と完全に一致する、と。そのうえで、「応相談4,000円は、表から100%確定できる事実ではなく、他の明細と小計から整合するように判断したもの」と認めています。
数字を出した時点では、どちらも、読み方の選び方が見えませんでした。次の図は、3つの答えが、決められない3つの行をどう読んだかを並べたものです。
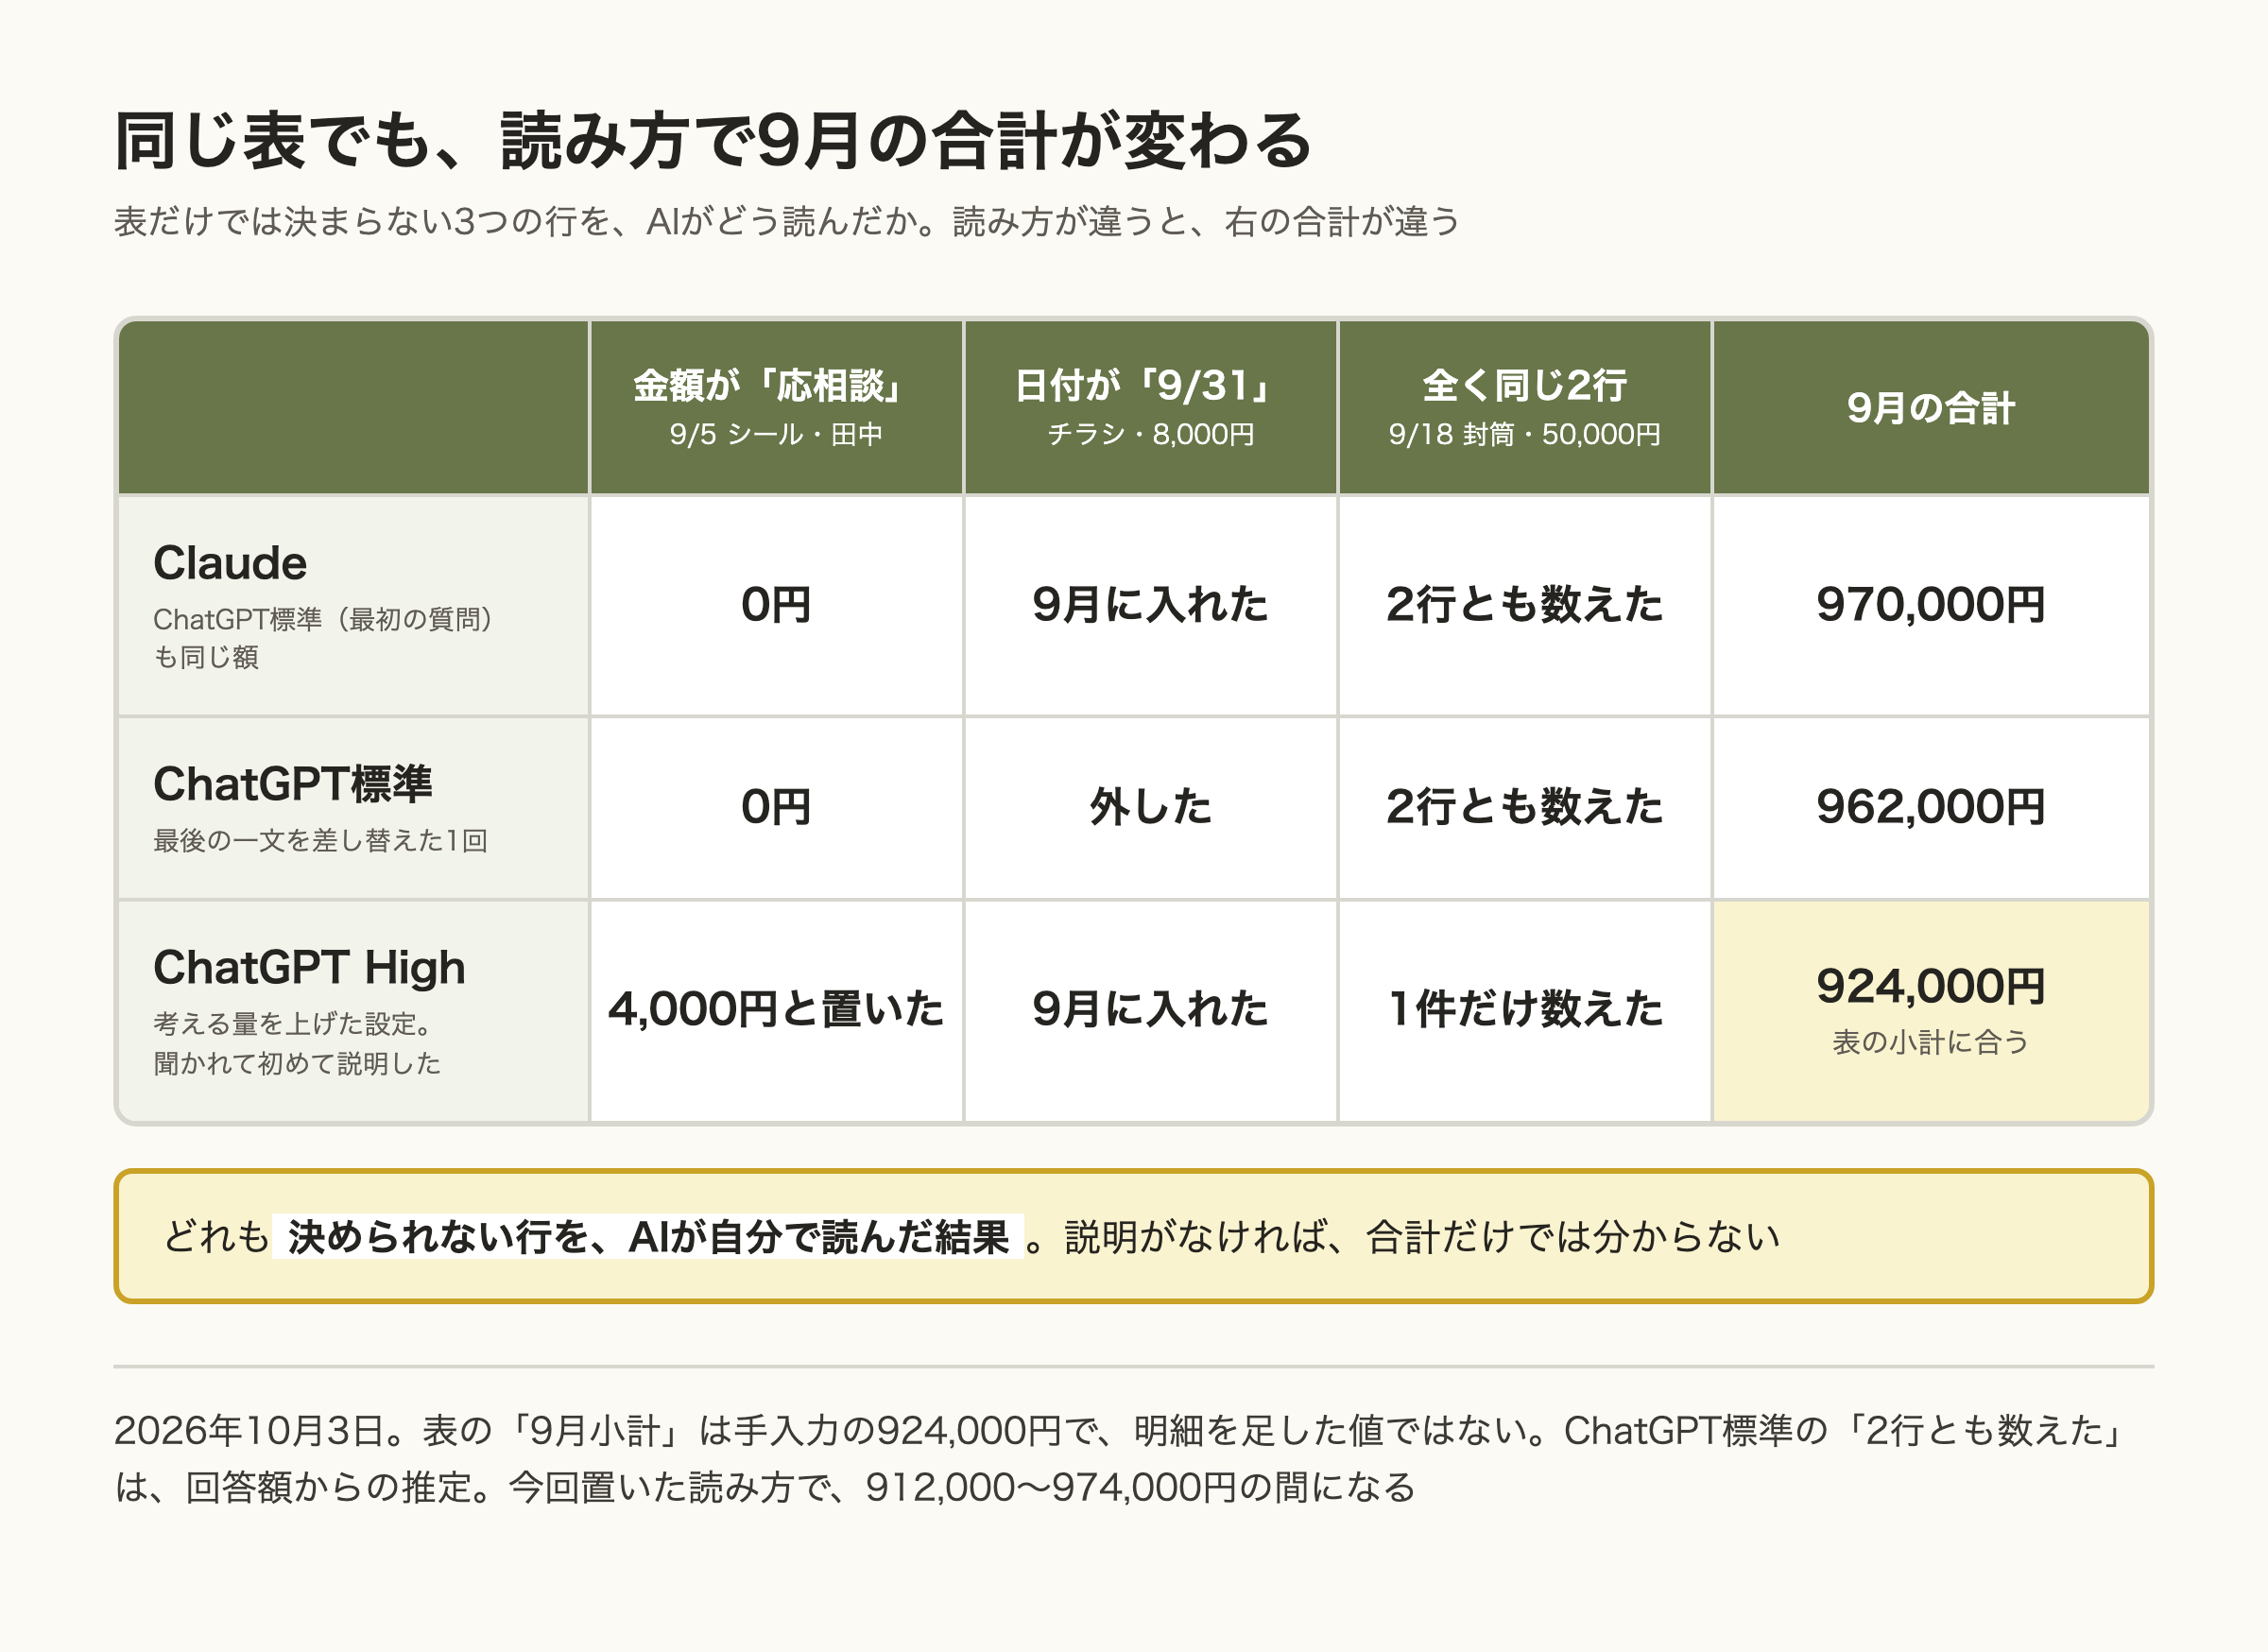
「小計に合わせる」のは、一見、堅実な方法に見えます。ただ、手で入れた小計が正しいとは限りません。小計に合うように、決められない行の値を埋めていけば、合っているように見える数字が出ます。人が見ても、合っているのか、合わせたのかは分かりません。
Claude:聞かれる前に5つとも書いた
Claude(Opus 5.5)は、最初の答えに、5つの行をすべて書きました。数字は、9月が970,000円、増えた額が117,000円で、ChatGPT(標準)の最初の答えと同じです。違ったのは、次の点です。
まず、9月の明細を足した970,000円が、表の「9月小計 924,000円」と合わないことを書き、「小計セルは数式ではなく手入力の数値なので、小計のほうが古いか誤っている可能性が高い」としています。8月は、明細の合計と小計の853,000円が一致していたことも添えていました。次に、全く同じ2行を、「両方を計上している。二重入力だった場合、9月は920,000円、増加額は67,000円、山田さんの通算は347,000円になる」と、別の数字まで出しました。最後に、「二重入力かどうかと『応相談』の金額が分かれば、数字を確定させられます」と、人に確かめてほしい点を書いて終わっています。
頼んだのは「数字だけ」でした。Claudeは、その指示に収まらない注意書きを付けました。数字だけが欲しい場面では、これは余計かもしれません。ただ、表に決められない行があるときは、この余計な部分が、確かめる先を教えてくれます。
Gemini:2回とも使える数字が出なかった
Gemini(Flash)は、2回目の表で、2回とも使える数字が出ませんでした。1回目は、1回目の表のときと同じ、「まだ学習中で対応できません」という文章でした。新しい会話でやり直すと、Googleの「どちらの回答がより有用ですか」という画面が出て、2つの案が並びました。1つは同じ断り文、もう1つは、このファイルにない「商品A」「高橋」という名前を含む、8月3,116,000円・9月4,685,200円という数字でした。どちらの案も選ばずに閉じています。
Geminiの結果は、2回の標準の画面で見えたことで、Geminiの力の評価ではありません。1回目の表では、やり直した回に4問とも正解でした。ただ、同じ質問でも、答えが出る回と出ない回があること、出た数字がこのファイルにないものだった回があることは、確かめられました。集計の結果が、毎回同じ形で返ってくるとは限りません。
最後の一文を差し替えると、一覧が先に出た
ここまでの結果から、頼み方の最後の一文を変えると、どうなるかを試しました。ChatGPT(標準)に、2回目の表で、質問の最後の一文を差し替えました。「金額は円で、数字だけ分かるように書いてください。」を、次の文に変えます。
差し替えた一文(質問の最後に置く)
数字を出す前に、表だけでは決められない行があれば、その行を一覧にして、どう扱ったかを書いてください。結果は、数字の前に、5つの行の一覧が出ました。行ごとに「表だけでは決められない点」と「今回の扱い」が書かれていて、応相談と約30,000は集計から外し、9/31は月が決まらないので集計から外し、担当者の空欄は売上に含めて担当不明とし、全く同じ2行は別の売上として両方入れる、という内容でした。数字は、9月が962,000円、8月が823,000円です。小計の924,000円と853,000円にも触れ、「小計欄を正解として逆算するのではなく、明細だけから確定できる範囲で集計しました」と書いていました。
この確認は1回です。同じ一文でも、毎回こうなるとは言えません。それでも、「数字だけ」と頼んだときには出なかった判断の一覧が、数字より先に出ました。決められない行があるかもしれない表では、「数字だけ」と頼まないほうが、確かめる材料が残ると考えています(1回の結果です)。
集計のあとに見る5つの点
AIが集計した数字を使う前に、人が見る点を5つにまとめました。今回の試験で、AIの答えのどこを疑えばよかったかから作っています。
AIに集計を任せたあとの確認表
【AIに集計を任せたあとの確認表】

1. 決められない行:AIは、金額や日付や担当者が決まらない行を、一覧にして挙げたか(挙げていなければ「挙げてください」と頼み直す)
2. 小計の行:表の中の「小計」を足し込んでいないか。小計は手入力の数字か、計算式か
3. 小計との差:明細の合計が小計と合わないとき、AIが小計に合わせていないか。どちらが古いかは、人が決める
4. 行の番号:AIが言った行を、自分でExcelの同じ番号の行で開いて見たか
5. 二重入力:全く同じ行がないか。あれば、担当者に確かめるまで数字を確定しない

・この表だけで正確さを保証するものではありません。不明な点は担当者に確かめ、採用した扱いと集計結果を照らし合わせてから使います
・どれかが「いいえ」なら、AIに挙げさせて、人が決めてから使うこの試験で言えないこと
この試験から言えることには、限りがあります。次の点は、確かめていません。
2回目の表では、ChatGPT標準、ChatGPT High、Claudeを各1回、Geminiを2回試しました。さらに、ChatGPT標準で質問の最後の一文を差し替えた試験を1回行いました。もう一度やれば、違う答えになるかもしれません。表は、架空の78行(2回目の表は79行)で、実際の会社にある何千行もの表、複数のシートがある表、式が入った表は試していません。ChatGPTの標準、GeminiのFlash、ClaudeのOpus 5.5という、各社の標準の画面での結果で、同じ強さのモデルの比較ではありません。特に、Claudeは上の段のモデルで、ChatGPTの標準やGeminiのFlashと同じ条件ではありません。ChatGPTはHighでも1回試しましたが、高い設定にすると注意書きが付く、という結果にはなりませんでした。
判断が必要な行と、検討する読み方は、私たちが設定しました。たとえば応相談を4,000円と置くのも、全く同じ2行を1件とするのも、読み方の1つです。AIの数字を「間違い」と呼ぶのではなく、「読み方を伝えたかどうか」で見ています。Excelの中で動くAI(Copilotなど)は試しておらず、同じ結果になるかは分かりません。
社長や同僚に説明するなら
社内で、AIにExcelの集計を任せたいという話が出たら、こう説明すると伝わりやすいと思います。
「AIに表を渡すと、今回の試験では数字が出る回が多くありました(出ない回もありました)。ただ、表に『応相談』や、存在しない日付や、全く同じ行があると、AIは自分で読み方を決めて、その数字を出します。決めたことを言わないAIもあります。だから、頼むときに『決められない行は、数字の前に一覧にして』と書き添えます。出てきた数字は、一覧を見て、人が決めてから使います」
ここまでは自分で。ここから先は決まりを作って
ここまでの頼み方と確認表は、1枚の表を、1人が試しに集計するためのものです。会社として、請求や在庫や給与の表をAIに触らせるなら、個人の注意に任せないほうが安全です。どの表ならAIに渡してよいのか、AIが挙げた「決められない行」を誰が見て決めるのか、決めた内容をどこに残すのか。こうした点は、会社として決まりを作っておきます。
よくある質問
ExcelをAIに読ませて、集計させて大丈夫ですか?
今回は、架空の表で試しました。実際の売上表や顧客の名前が入った表を、AIの画面にアップロードしてよいかは、会社の決まりと、使うAIの設定を確かめてから決めます。この試験では、そこは確かめていません。
数字が合っていれば、そのまま使ってよいですか?
今回の1回目の表(ふつうの乱れだけ)では、ChatGPTとClaudeの数字は合っていました。2回目の表のように、表だけでは決められない行があるときは、数字が合っているかどうかを人が確かめる方法がありません。AIが読み方を伝えているかどうかが、確かめる材料になります。
「数字だけ」と頼んではいけませんか?
表がきれいで、決められない行がないと分かっているなら、数字だけの頼み方でも差し支えないと考えられます(今回の試験では、その場合の確認は1回です)。決められない行があるかもしれないときは、「決められない行は、数字の前に一覧にして」と頼むほうが、材料が残ります。今回、ChatGPT(標準)で1回試して、一覧が数字より先に出ました。
どのAIが一番よかったですか?
元の「数字だけ」の頼み方では、追加で聞かなくても5種類すべてを説明したのはClaude(Opus 5.5)でした。質問の最後の一文を差し替えた追加の試験では、ChatGPT標準も最初の答えで5種類を挙げています。各1回で、画面の段も同じではないので、どれが一番よいとは言えません。
「ChatGPT for Excel」「Claude for Excel」のように、Excelの中で使うAIでも同じですか?
今回は試していません。この試験は、各社のウェブの画面にExcelのファイルを読み込ませたものです。Excelの中で使うAI(Copilotなども含む)で同じ結果になるかどうかは分かりません。
HaruIroAIはこう考える
今回の試験で、一番意外だったのは、数字の正しさが、ほとんど分かれ目にならなかったことです。ふつうの乱れなら、どのAIも直して集計しました。分かれたのは、決められない行を、人に返したかどうかです。
今回の架空の表では、正しく集計できた回がありました。それでも、決められない行をどう読むかを決めるのは、表を持っている人です。AIが読み方を黙って決めていないか。数字の前に、それを見られる頼み方にしておくことが、任せるときの最初の備えになります。
この記事の確かめ方
2026年10月3日に、各社のウェブの画面で試しました。ChatGPTは標準の設定(Instant)と、考える量を「High」にした設定、Geminiは標準のFlash、ClaudeはOpus 5.5(標準の設定)です。画面の操作は、AIが行いました。表は、スクリプトで作った架空の売上明細で、1回目の表(sales.xlsx)は、明細78行に、文字の金額10件、文字の日付12件、商品名のゆれ10件、月の小計2行、空行1行、返品2行を入れたものです。2回目の表(sales2.xlsx)は、1回目の表の4行を、金額「応相談」、金額「約30,000」、日付「9/31」、担当者の空欄に書き換え、全く同じ行を1行足したもの(明細79行)で、月の小計はそのままにしました。質問は、どのAIにも記事に載せた同じ文章で、新しい会話に、ファイルを添付して送りました。聞き直しの文は、1回目の表では「表の中に、そのまま足すと間違えてしまう箇所はありましたか?あれば、どこにあって、どう扱ったかを教えてください。」、2回目の表では「表の中に、そのまま足すと間違えてしまう箇所や、表だけでは決められない箇所はありましたか?あれば、どこにあって、どう扱ったかを教えてください。」です。1回目の表の正解は、作った表から計算して決めました。今回置いた読み方の組み合わせでは、9月の合計は912,000〜974,000円、8月は823,000〜861,000円になります。これは実際の売上の上下限ではなく、8月の上限には、日付不明の8,000円を8月に含める読み方も入っています。2回目の表には、表だけから1つに決まる合計を正解として置いていません。AIが置いた読み方で明細を計算した値と回答が一致するか、読み方を説明しているかで見ました。ChatGPTの標準で、質問の最後を差し替えた確認は1回です。Geminiは、各表で2回ずつ試し、結果はそのまま載せました。Googleの2案を比べる画面は、どちらも選ばずに閉じています。AIの回答の数値と主要な発言の抜粋・要約、会話のリンク、表を作ったスクリプトは、確かめ記録として保存しています。