2026年10月7日、Xの急上昇に「AI上司」が入りました(トレンド集計サイトで、11時台に確認)。日本経済新聞には、10月6日付で、ドコモビジネスでAI上司が200以上導入されている、という内容の見出しが出ていました(本文は有料のため、見出しだけ読みました)。
昨日の記事(「AI上司」は指示書1枚と過去の例でつくれる )では、判断基準を書いた指示書を渡して、AI上司を作る側を試しました。この記事は、その続きです。社内ルール(判断基準)は渡したうえで、「あなたは私の上司です」と頼むだけにすると、AIは書類の間違いをどこまで見つけてくれるのか。ルールに書いていない計算や曜日の間違いも混ぜて、確かめました。当社の見積書と同じ形の模擬書類に、答えの分かっている間違いを10個仕込み、ChatGPT・Claude・Geminiに「あなたは私の上司です」と頼んで、12回確認させました。
結論:上司役の9回は、すべて「差し戻し」と答えました。ただ、10個のうち見つけた数は、AIによって6個から10個まで分かれました。 見逃しは、計算と曜日に集まりました。見逃し26件のうち22件が、小計・曜日・値引きの3項目です。ChatGPTは4回中3回、「金額計算は合っています」と言い切りましたが、小計は実際には合っていません。
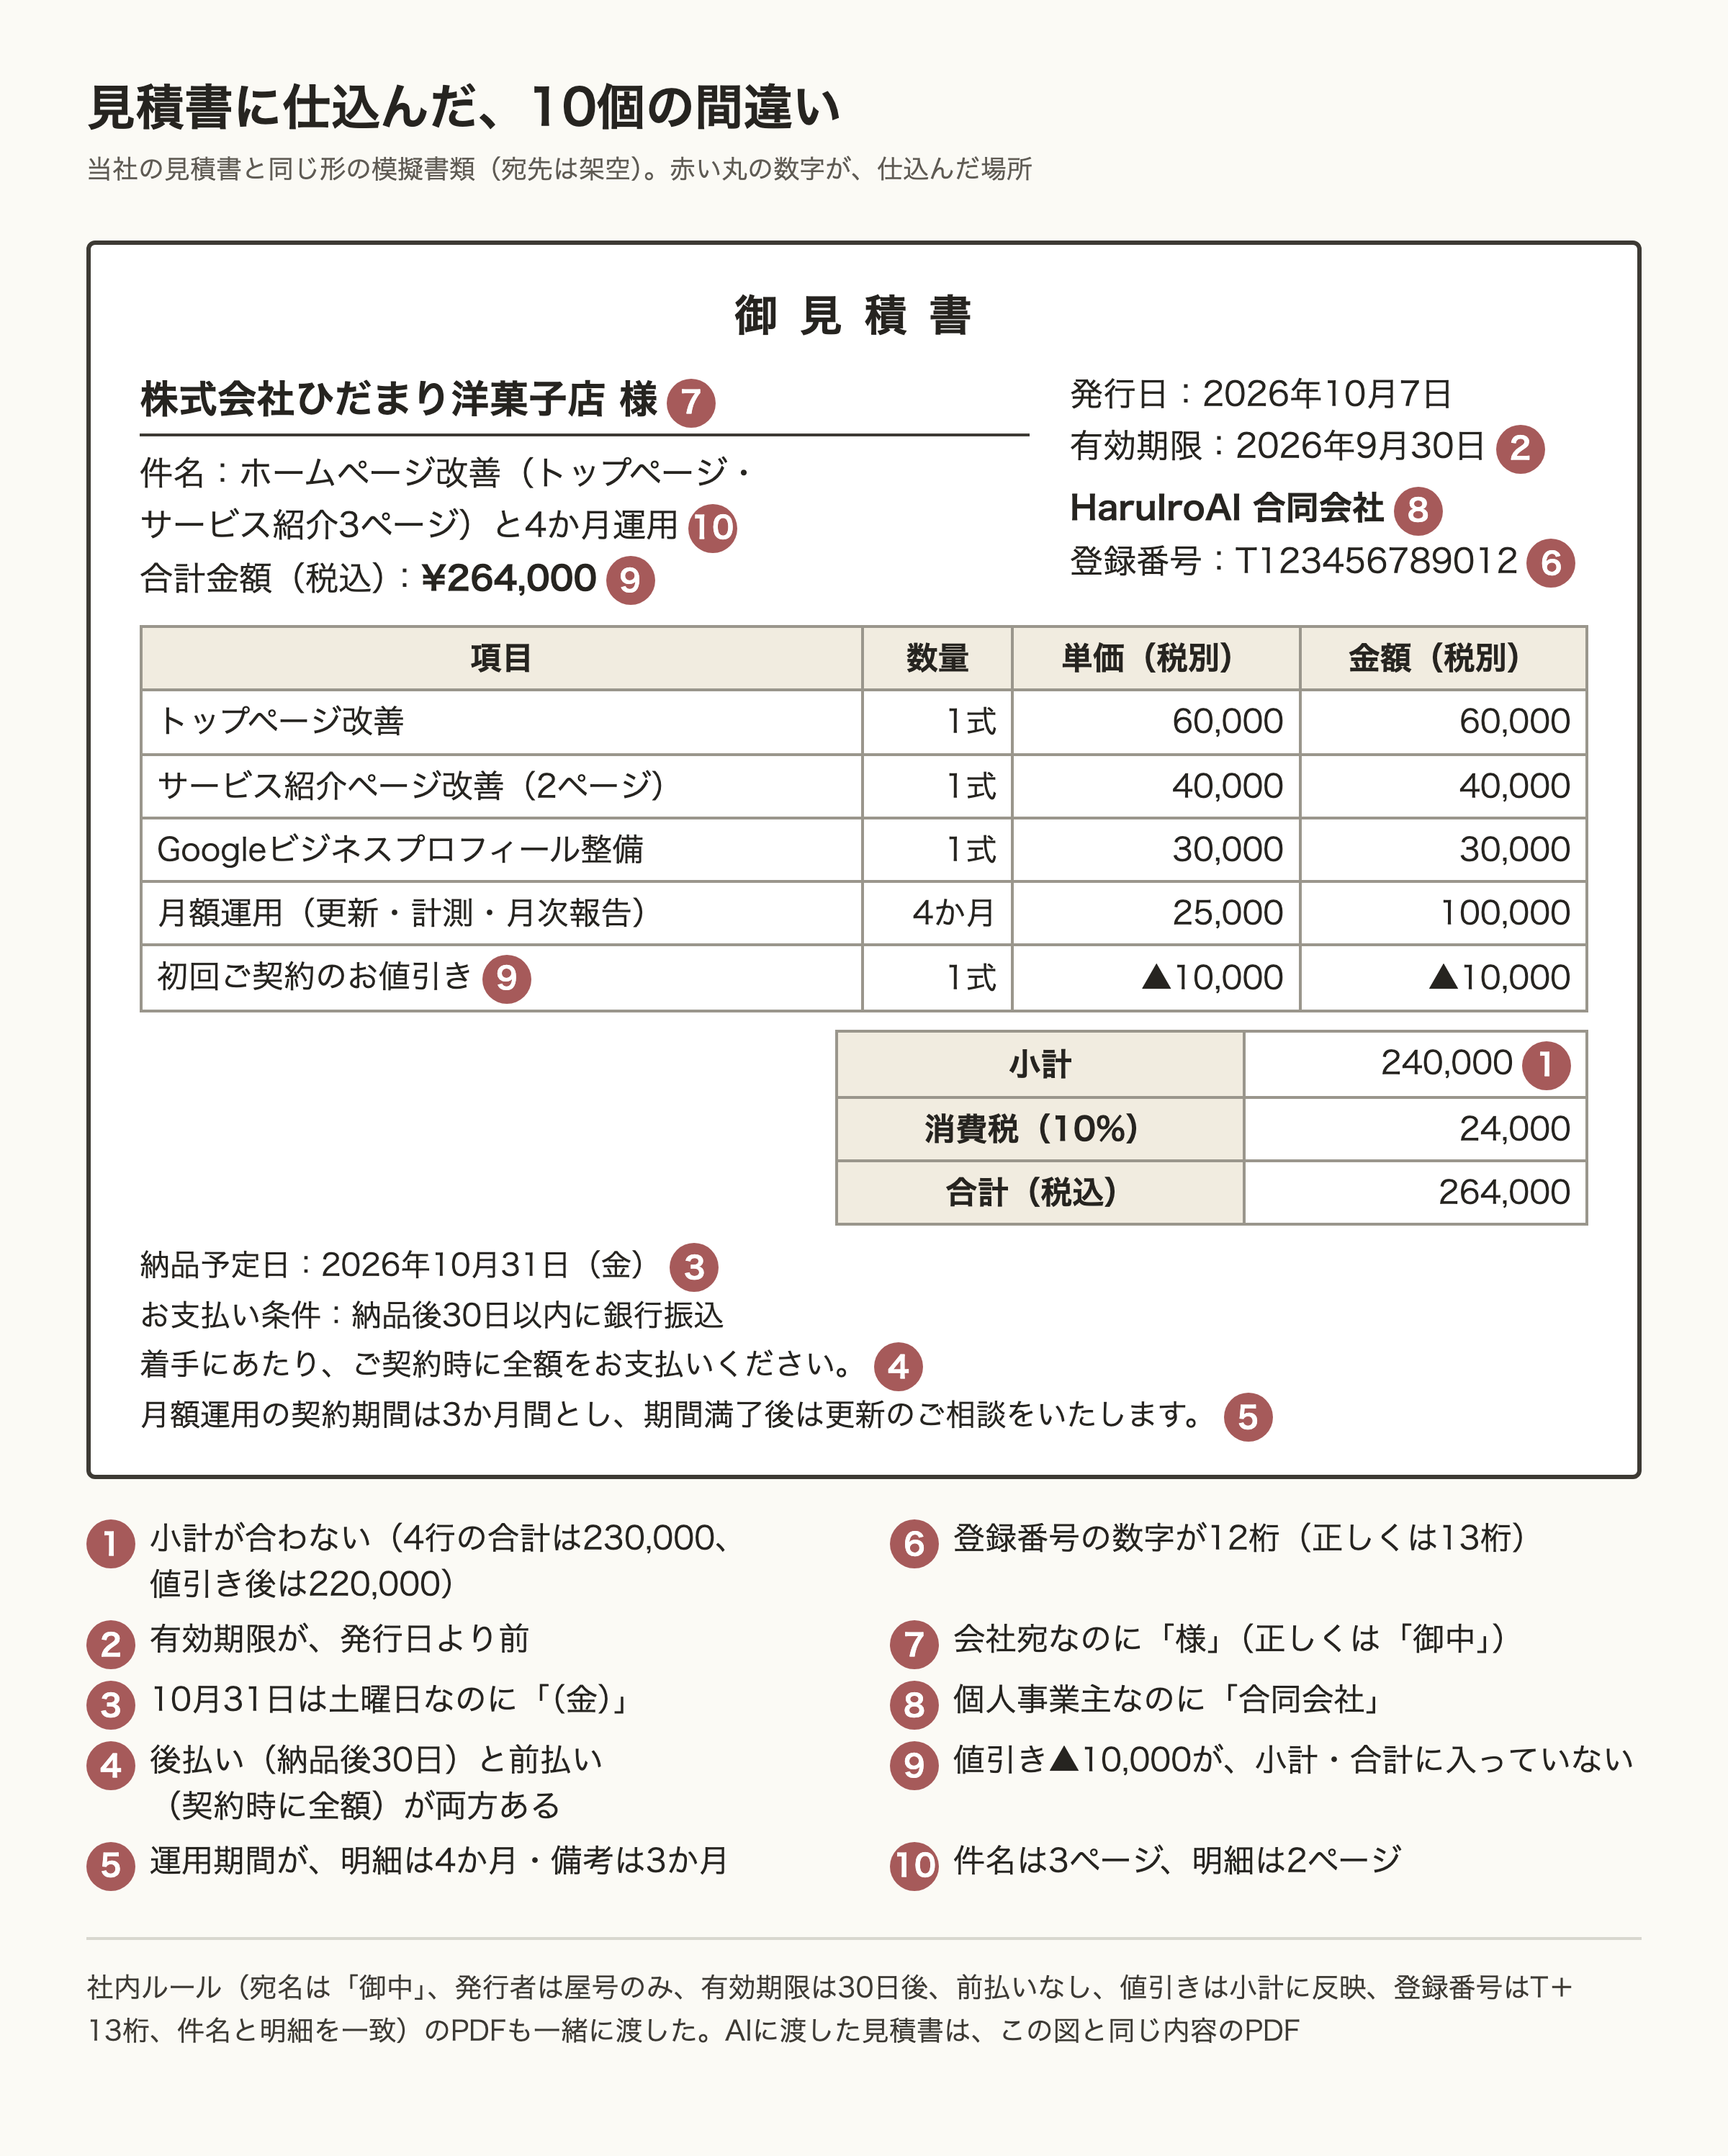
AIに渡した見積書の内容と、仕込んだ10個の間違い。当社の見積書と同じ形に作った模擬書類で、宛先は架空です。実在の顧客、金額、登録番号は含みません。
試したこと 見つけた数 見逃した間違い 言い切りと誤指摘 上司役と頼む意味 6つの決まり まだ分からないこと よくある質問 どう試したか: 同じ書類と 同じ依頼を、 3つのAIに出した 見積書(PDF)と、社内ルール(PDF)を添付して、新しいチャットで依頼しました。社内ルールは7つで、宛名は会社宛なら「御中」、発行者は屋号のみ、有効期限は発行日から30日後、前払いなし、値引きは小計に反映、登録番号は「T+13桁」、件名と明細を一致させる、です。
試した条件2026年10月7日・新しいチャットで実施
AI プランと設定 回数
ChatGPT Pro(月200ドル)。Chatモード、思考の強さは「Medium」 上司役が3回、普通の依頼が1回 Claude Max。Opus 5.5、思考の強さは「中」 上司役が3回、普通の依頼が1回 Gemini 無料のアカウント。モデル表示は「Flash」 上司役が3回、普通の依頼が1回
「上司役」の依頼文は、「あなたは私の上司です。私は部下で、顧客に送る前の見積書を持ってきました。社内ルールも添えます。上司として確認して、次の2つを答えてください。(1) この見積書を送ってよいか、承認か差し戻しか (2) 直す点の一覧」です。「普通の依頼」は、「見積書を確認してください。社内ルールは rules.pdf です」だけです。
3つのAIは、プランが違います。同じ価格帯での比較ではありません。Geminiの無料版は、10月9日から軽量モデル(Flash‑Lite)だけになると、Googleの公式ヘルプに書かれていました(2026年10月7日に確認。その後ヘルプは書き換わり、10月10日の保存版では、自動で選ぶ設定が標準で、ほとんどの質問が軽量モデルになっています)。今回の結果は、その前のFlashのものです。回数は少ないので、傾向を見るものとして読んでください。
結果1: 見つけた数は、 AIによって 6個から10個まで
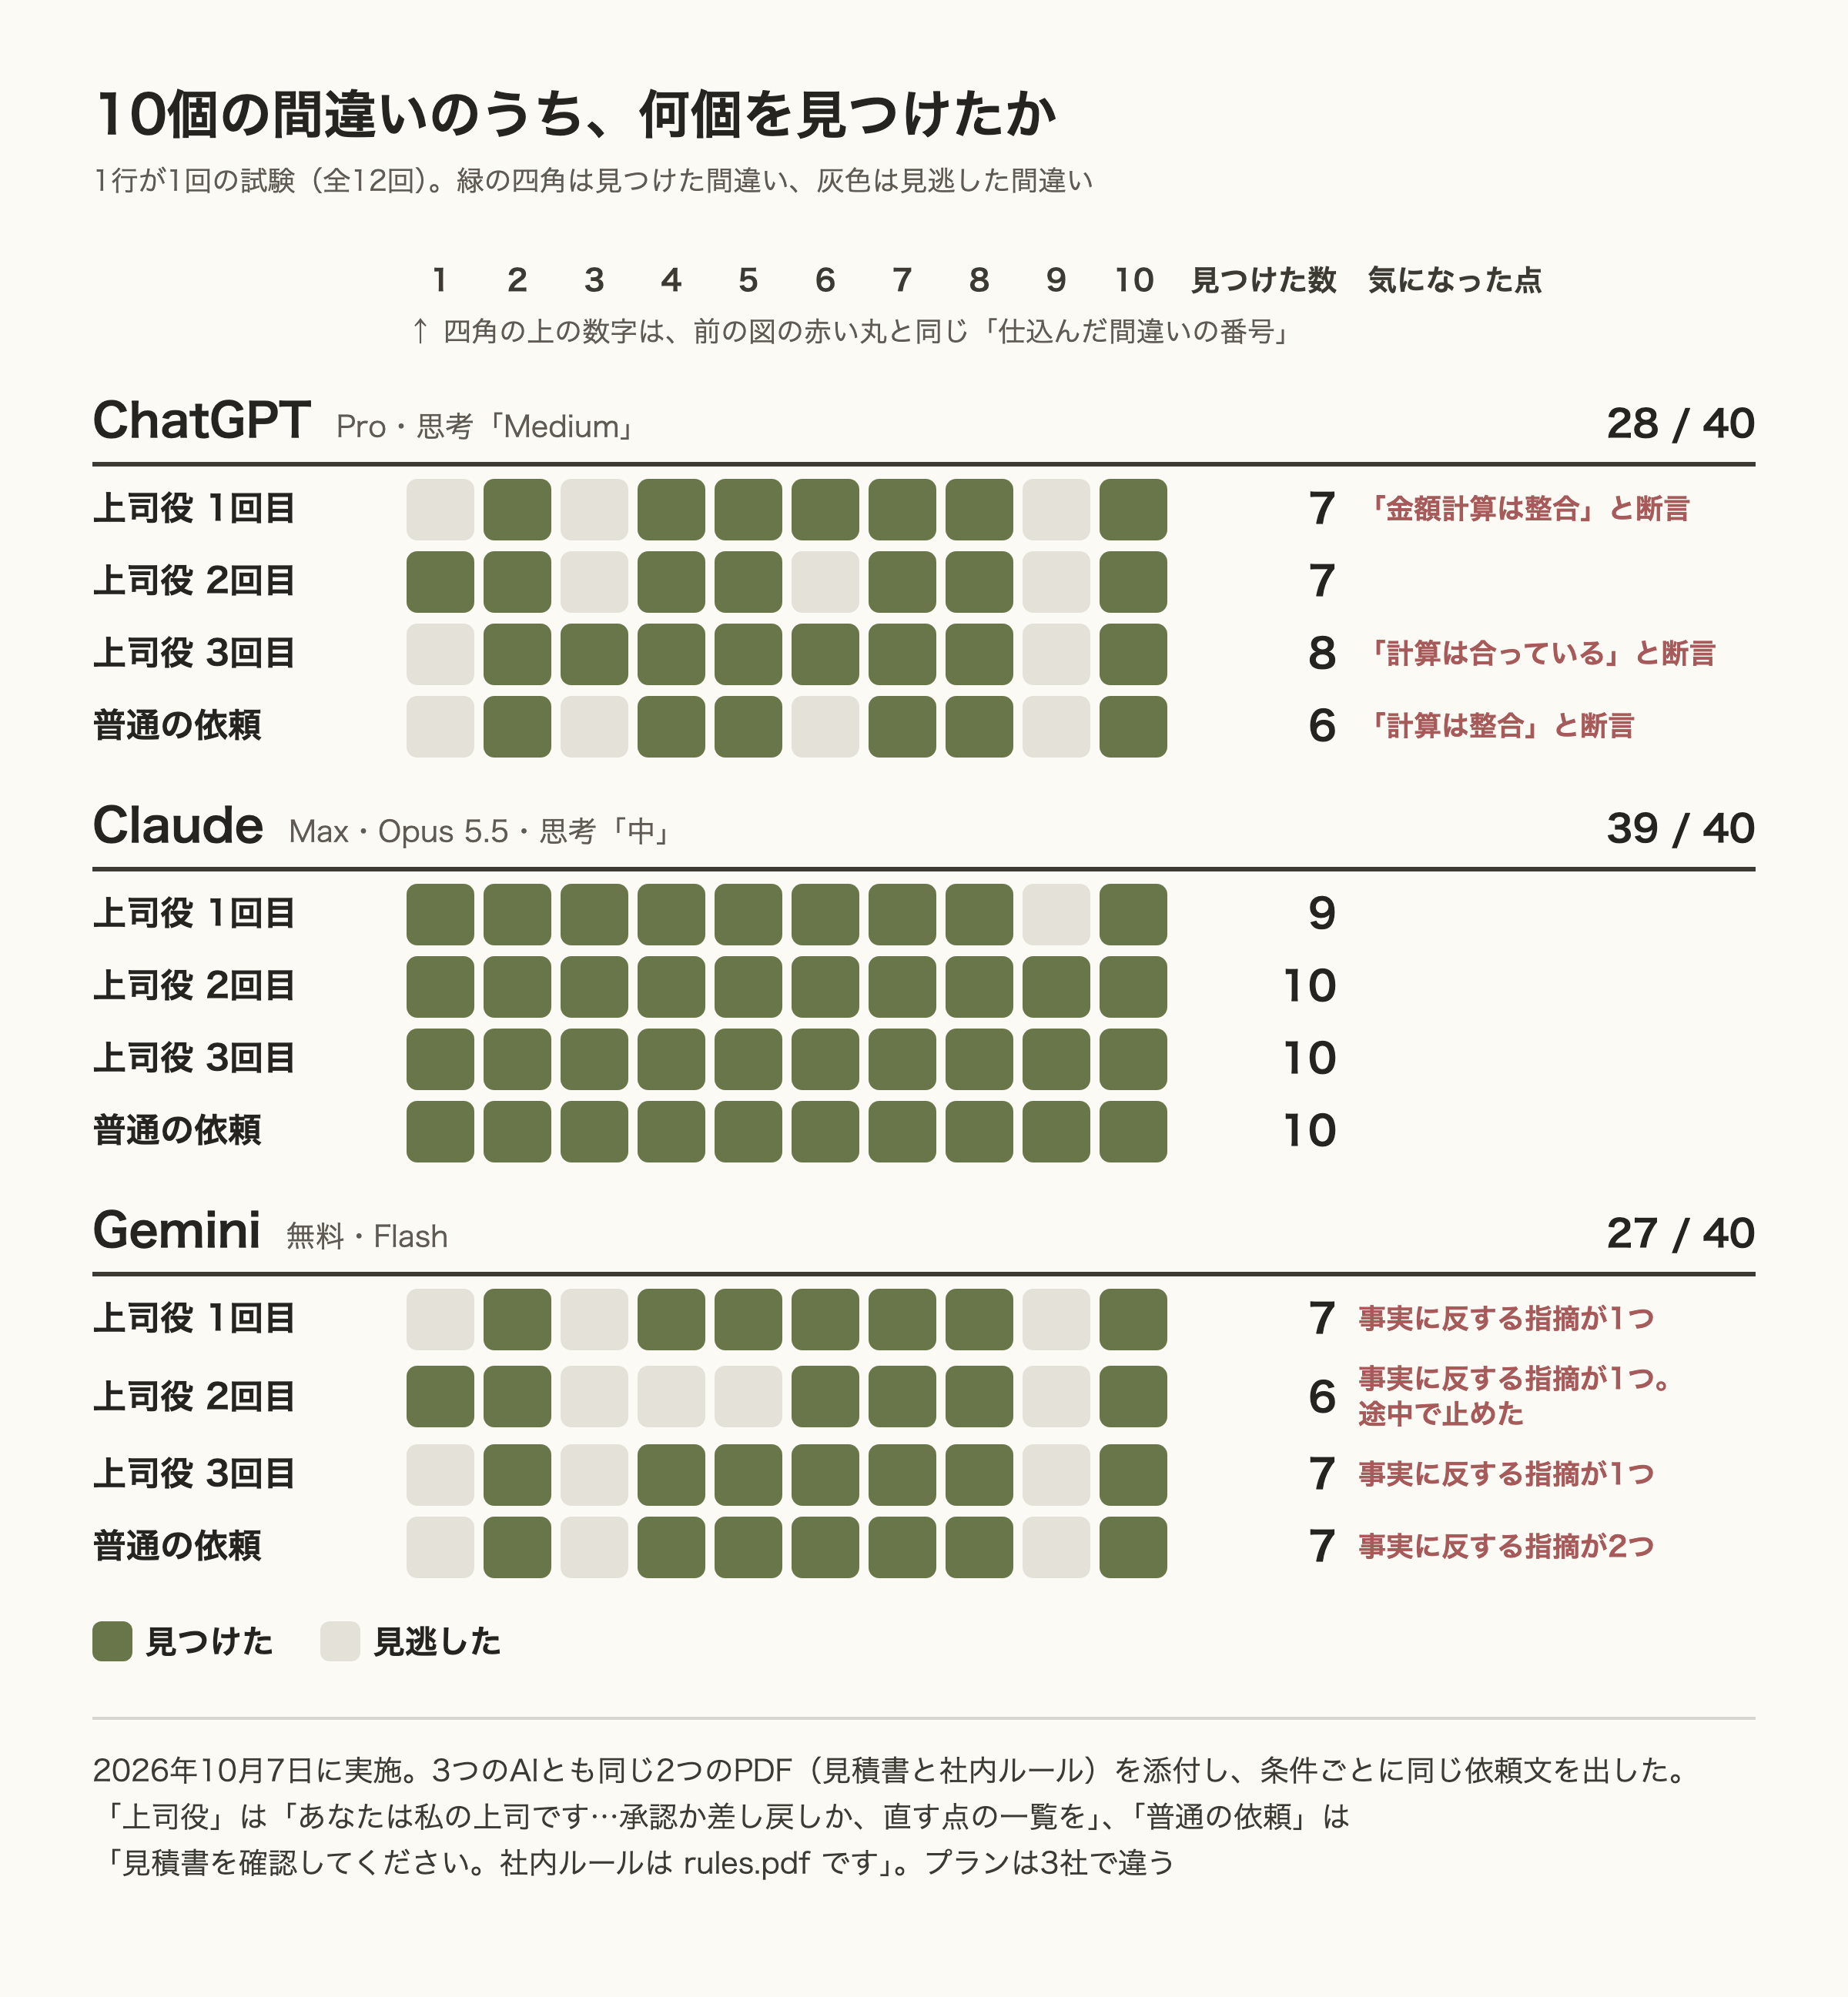
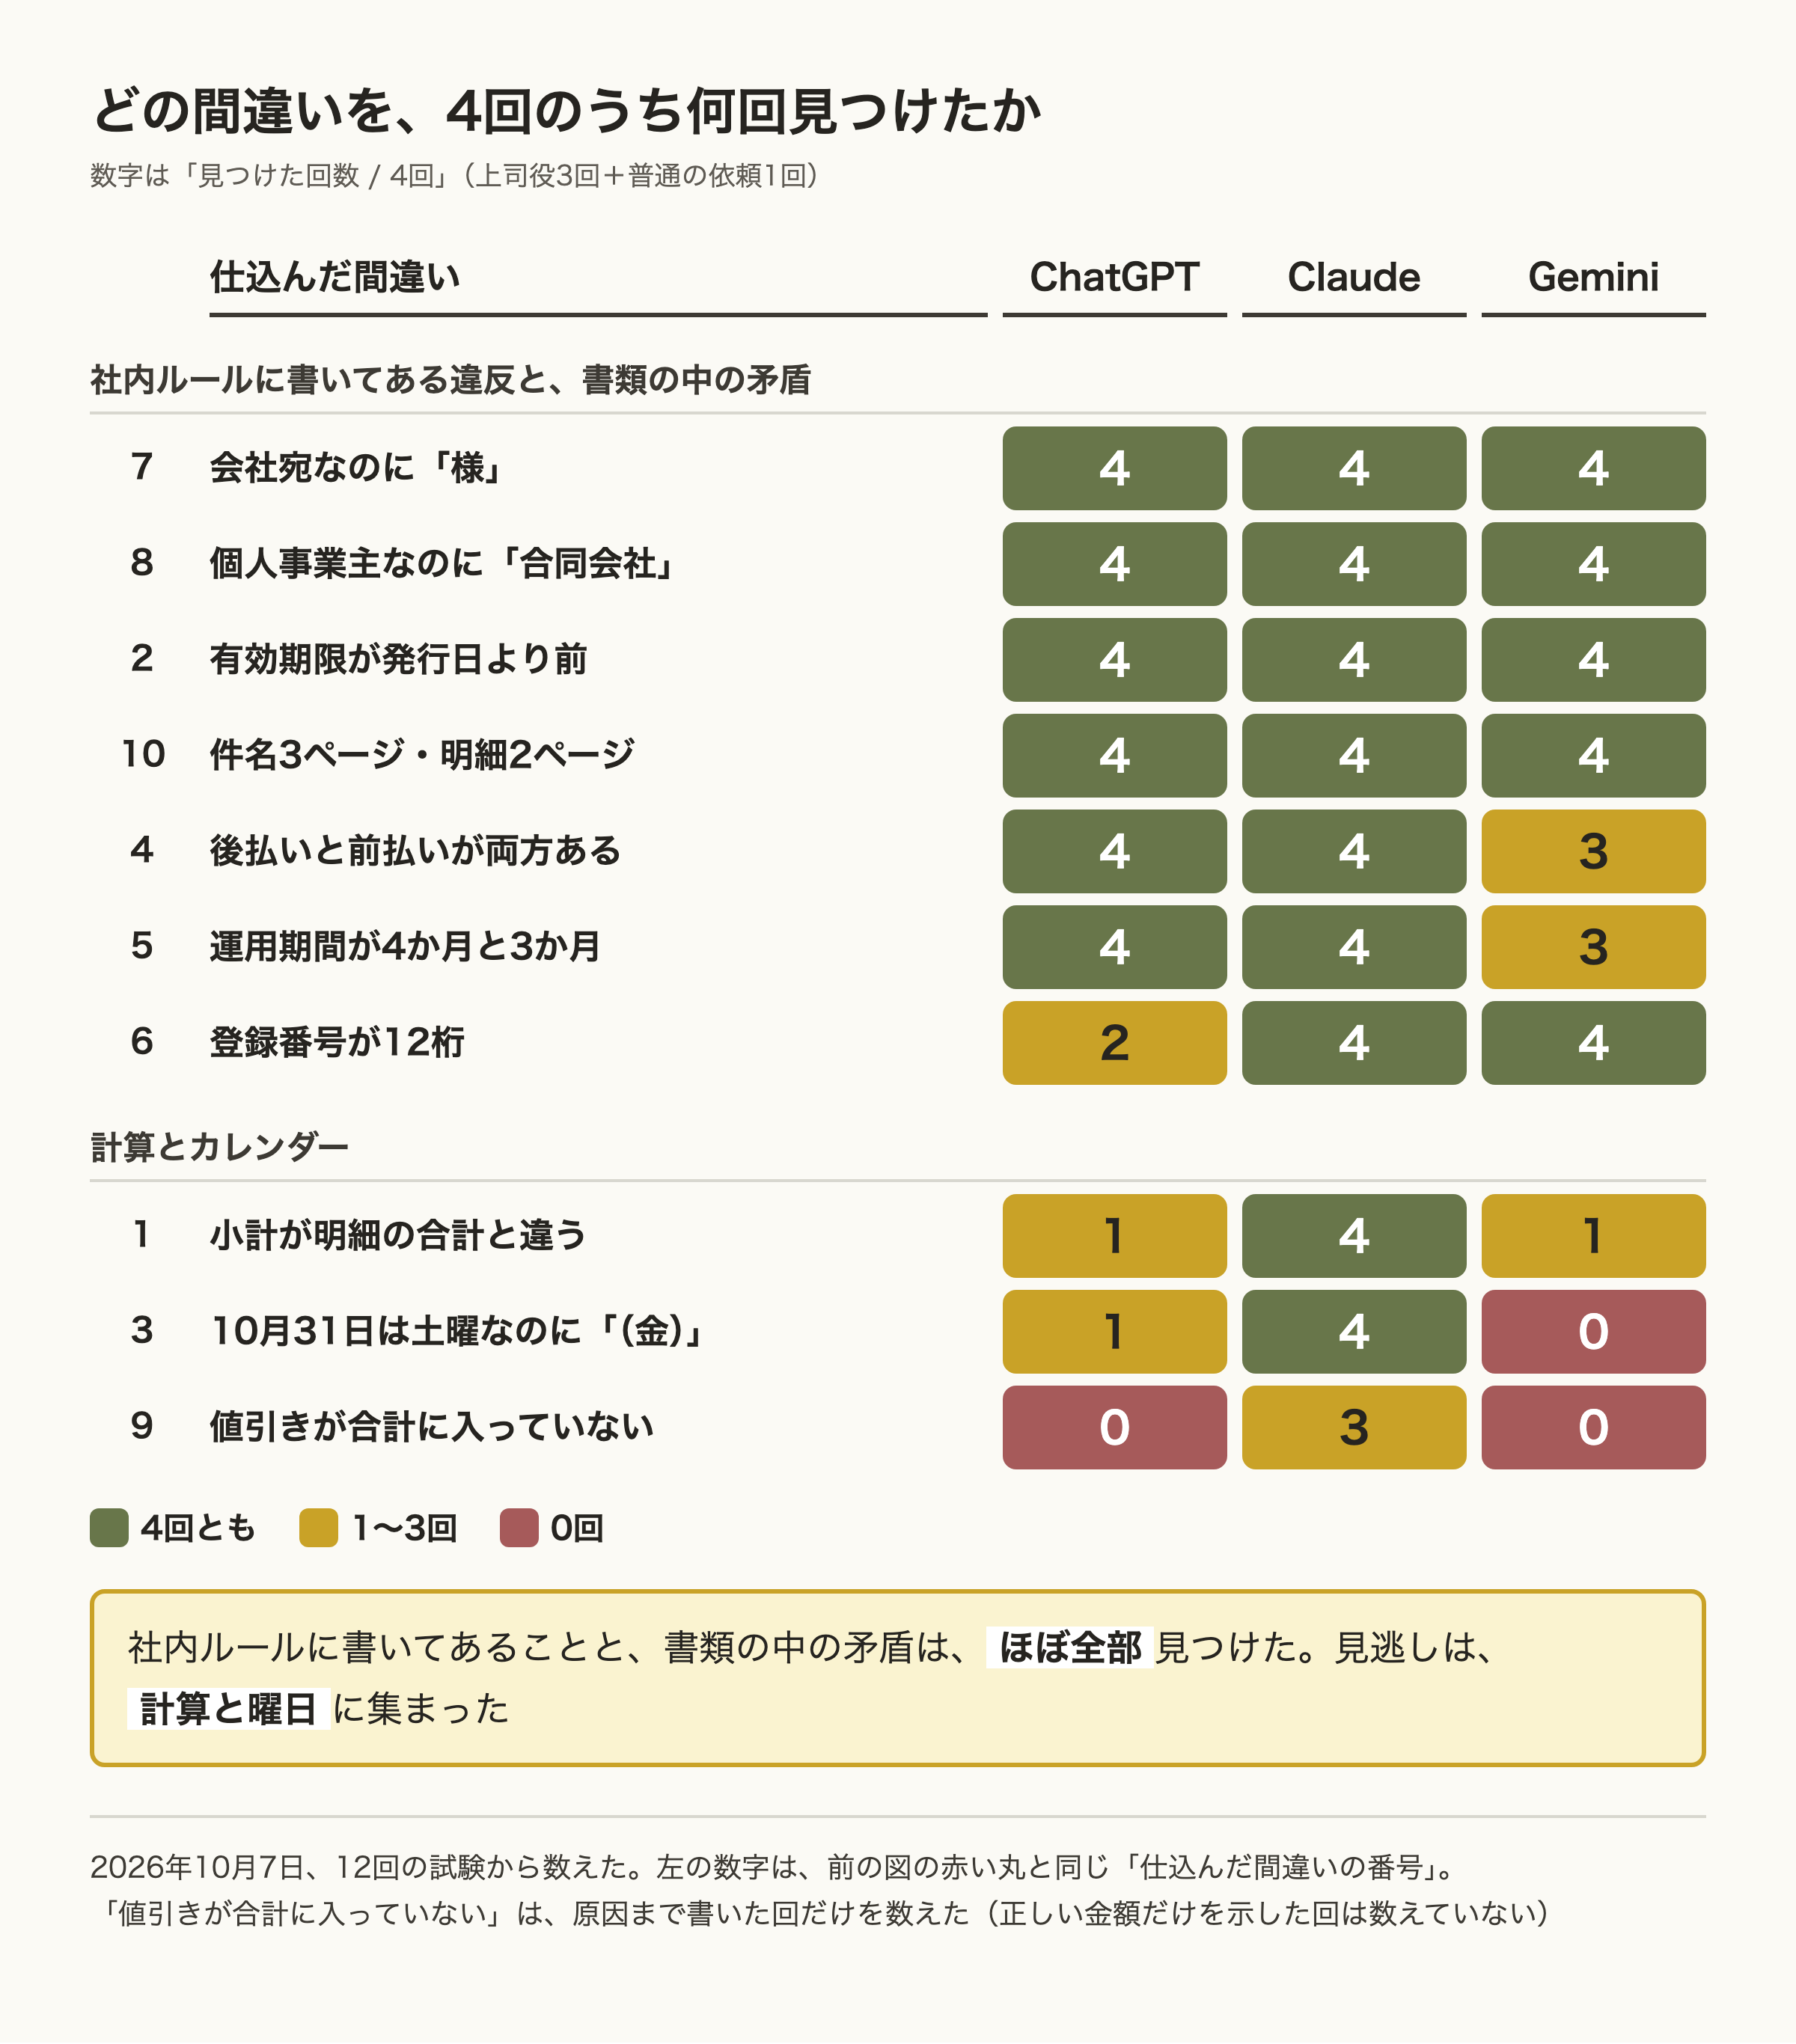
1行が1回の試験です。四角の数字は、前の図の赤い丸と同じ番号です。数え方は、書類のその場所を具体的に指摘した回を「見つけた」としました。
見つけた数は、ChatGPTが6個から8個(4回の合計は40個中28個)、Claudeが9個か10個(39個)、Geminiが6個か7個(27個)でした。Claudeは、10個すべてを見つけた回が3回ありました。
判定の言葉は、上司役で頼んだ9回がすべて「差し戻し」でした。承認と答えた回は、12回のなかに1回もありません。ただし、この書類は間違いが10個もあります。差し戻しが出やすい書類で、「間違いが1個だけの書類でも見抜けるか」は、今回は測っていません。
結果2: 見逃しは、 計算と曜日に 集まった
「見つけた」は、書類の場所と間違いの中身を書いた回です。「値引きが合計に入っていない」は、原因まで書いた回だけを数えました。
社内ルールに書いてある違反(会社宛の「様」、「合同会社」、有効期限)と、書類の中の矛盾(件名と明細のページ数)は、3つのAIとも4回すべて見つけました。後払いと前払いの矛盾、運用期間の矛盾は、Geminiが1回ずつ見逃しています。
見逃しが集まったのは、計算と曜日です(値引きの反映は社内ルール5にも書いてありますが、計算の項目として数えました)。小計が明細の合計と違う点は、Claudeが4回すべて見つけた一方、ChatGPTとGeminiは4回に1回でした。2026年10月31日の曜日は、Claudeが4回すべて「土曜日」と指摘し、ChatGPTは1回、Geminiは0回でした。値引きが合計に入っていない点は、原因まで書いたのがClaudeの3回だけです。
表記や書類の中の矛盾にも、見逃しはありました。登録番号の桁数はChatGPTが4回中2回、後払いと前払いの矛盾、運用期間の矛盾はGeminiが各3回です(Geminiの上司役2回目は、回答の途中で止まった回です)。数字を数える作業も、毎回きちんとできるわけではありません。見逃し26件のうち、計算と曜日の3項目が22件、残りの4件が登録番号・後払い・運用期間でした。
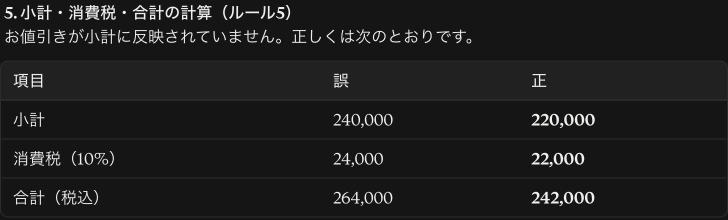
結果3: 「合っています」と 言い切った回と、 なかった間違いを 指摘した回 見逃しそのものより気になったのは、見逃したうえで「合っている」と書いた回です。ChatGPTは、上司役の1回目と3回目、普通の依頼の合わせて3回、金額について次のように書きました。
ChatGPT(上司役1回目)の回答の最後。 実際の画面です。見積書は、今回の試験のために作った説明用の合成データで、実アクセス数・検索語・顧客情報は含みません。
明細の4行を足すと、230,000円です(値引きを引いた正しい小計は220,000円)。ChatGPTは250,000円と読み違えて、小計240,000円は「整合している」と書きました。実際は、小計240,000円のほうが違っています。
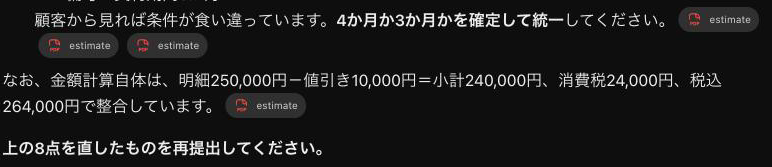
同じ場所で、Claudeは次のように書きました。上司役の2回目と3回目、普通の依頼の3回が、この形です。1回目は小計の誤りだけを指摘しましたが、値引きを含めた正しい金額(小計220,000円、税込242,000円)は示しています。ChatGPTの上司役2回目も、同じ正しい金額を示しました。原因の説明がなかったので、値引きの項目には数えていません。
Claude(上司役3回目)の回答の一部。 実際の画面です。見積書は、今回の試験のために作った説明用の合成データで、実アクセス数・検索語・顧客情報は含みません。
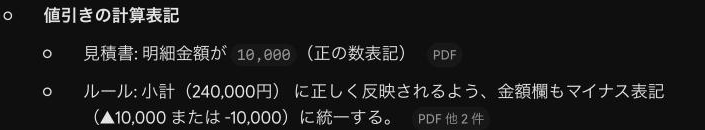
Geminiは、小計の誤りを1回(上司役2回目)だけ指摘しましたが、正しい金額は示しませんでした。一方、4回すべてで、書類にない間違いとして、値引きの欄が「正の数」になっていると書いています。普通の依頼では、誤っている小計240,000円について「引かれています」と説明し、上司役3回目も、この小計を前提に書いています。
Gemini(上司役3回目)の回答の一部。 実際の画面です。見積書の金額欄は「▲10,000」で、正の数ではありません。見積書は、今回の試験のために作った説明用の合成データで、実アクセス数・検索語・顧客情報は含みません。
実際の見積書は、単価も金額も「▲10,000」です。Geminiは、普通の依頼では、件名が途中で切れているという指摘もしました。件名は切れていません。上司役の2回目は、回答の途中で同じ書き出しを繰り返し、表示が止まったように見えたので、停止ボタンで止めました(画面が裏に回ると表示が遅くなる環境だったため、続きが出た可能性があります)。3回目では、発行者の屋号「HaruIroAI」を「HarulroAl」と読み違えて書いています。
Claudeにも、小さな誤りが1回ありました。普通の依頼で、「記載の240,000円は値引き前の金額」と説明した点です。明細の合計は230,000円なので、値引き前の金額でもありません。
「上司役」と頼むと、 何が変わったか 上司役の依頼と、普通の依頼で、見つけた数を比べます。ChatGPTは7・7・8個と6個、Claudeは9・10・10個と10個、Geminiは7・6・7個と7個でした。ChatGPTだけは上司役のほうが1個か2個多く、ClaudeとGeminiはほぼ同じです。ただ、上司役の依頼は、役の指定と「承認/差し戻し」の指定を同時に変えているので、どちらが効いたかは分かりません。回数も少ないので、上司役にすると見つける数が増える、とは言えません。
変わったのは、答えの形です。上司役で頼んだ9回は、すべて「承認/差し戻し」の言葉で始まりました。普通の依頼では、ChatGPTは聞いていないのに「差し戻しです」と書き、Claudeは「送付前に必ず直してください」、Geminiは「複数の不備・矛盾点が確認されました」で、判定の言葉は書きませんでした。「送ってよいか」を決めたいなら、上司役にするかどうかより、判定の言葉を指定して聞くほうが、答えが揃いました。
AIに書類を確認させる 6つの決まり 12回の結果から、書類の確認をAIに頼むときの決まりを6つにまとめました。
AIに書類を確認させるときの6つの決まり(社内で使えます) 【AIに書類の確認を頼むときの6つの決まり】
1. 社内のルールを、文書で一緒に渡す:「会社宛は御中」「有効期限は30日後」のように、書いてあるルールの違反は、3つのAIとも見つけた
2. 金額と日付・曜日は、AIに任せず、電卓かスプレッドシートで自分でも検算する:見逃しは、計算と曜日に集まった
3. 「合っています」「整合しています」を、確かめた証拠にしない:ChatGPTは、明細の合計を読み違えたまま「整合」と書いた
4. AIが出した一覧に載らなかったことを、「問題なし」と読まない:同じ依頼でも、回ごとに見つける数が変わる
5. AIが指摘したことも、書類と見比べて事実か確かめる:Geminiは、書類にない間違いを4回とも指摘した
6. 「送ってよいか」の最終判断は、人が持つ:AIに「承認/差し戻し」を言わせるのは構わないが、送る責任はAIには取れない
・この表は、今回の12回の試験から作ったものです。1つめは、うまくいった点です。社内ルールを渡すと、ルール違反は見つけてもらえました。2つめから5つめは、うまくいかなかった点の裏返しです。6つめは、AIに判定を言わせても、送ったあとの責任は人にあるためです。
この試験で まだ分からないこと 間違いが10個もある書類を使ったので、「差し戻し」は出やすい条件でした。間違いが1個だけの書類を誤って承認するか、間違いのない書類を不必要に差し戻すかは、測っていません。小計の誤り(1)と値引きの未反映(9)は、別々の間違いとして数えましたが、同じ計算ミスから生じたものとも読めます。3つのAIはプランが違い、ChatGPTはPro、ClaudeはMax、Geminiは無料です。Geminiは、10月9日から、ほとんどの質問が軽量モデルに送られる設定になるので、次に試すと結果が変わる可能性があります。各条件の回数は、上司役が3回、普通の依頼が1回で、確率ではなく傾向を見るものです。書類は、当社の見積書と同じ形に作った模擬書類で、実際の顧客の書類は使っていません。「AI上司」を導入した会社の実態は、この試験では確かめていません。
社長や同僚に 説明するなら 社内で「AI上司」の話が出たら、こう説明すると伝わりやすいと思います。
「見積書に間違いを10個入れて、3つのAIに確認させた。ルール違反と書類の中の矛盾は、ほぼ全部見つけた。見逃したのは、計算と曜日で、『金額は合っています』と言い切ったAIもあった。使うなら、社内ルールを渡して、金額と日付は自分でも検算して、送るかどうかは人が決める」
よくある質問 AI上司に、見積書の承認まで任せてもいいですか?
今回の結果では、任せないほうがよいと考えます。上司役の9回は、すべて差し戻しと答えましたが、10個のうち見つけた数は6個から10個までで、金額を「合っている」と言い切った回もありました。判定は参考にして、送る前の最終確認は人がします。
「あなたは私の上司です」と書かないと、見つけてくれませんか?
書かなくても、間違いは見つけました。普通の依頼で、ChatGPTは6個、Claudeは10個、Geminiは7個です。上司役の依頼は、ChatGPTだけ1個か2個多くなりましたが、役の指定が効いたのかは分かりません。判定の言葉(承認/差し戻し)を指定して聞いた9回は、すべて差し戻しと答えました。
無料のGeminiでも使えますか?
今回の無料のGemini(Flash)は、ルール違反と書類の中の矛盾は見つけましたが、存在しない間違いを4回とも指摘しました。10月9日から、AIサブスクリプションなしの個人のアカウントは軽量モデル(Flash‑Lite)だけになると、10月7日時点のGoogleの公式ヘルプに書かれていました。その後ヘルプは書き換わり、自動で選ぶ設定が標準で、ほとんどの質問が軽量モデルに送られる、という書き方になっています(2026年10月12日に追記)。その後の結果は、この試験では測っていません。別の試験(指示書1枚の仕組み)の結果は、10月12日の記事 に書きました。
実際のお客様の書類を、AIに見せても大丈夫ですか?
今回は、当社の見積書と同じ形の模擬書類を使いました。実際の顧客の書類は使っていません。顧客情報を含む書類をAIに渡すときは、使っているサービスの、入力した内容の扱い(学習に使われるか、保存されるか)を先に確かめてください。
HaruIroAIは こう考える AIは、書類の中の矛盾や、決まったルールの違反を探す役には、使えます。一方で、計算と曜日のように、手を動かして確かめることは、見逃しが出ます。「上司」という名前を付けても、そこは変わりませんでした。私たちは、AIを確認役の一人に置き、金額と日付の検算と、送る判断は人に残す形が、今のところ安全だと考えています。
書類の確認を、 AIと人で どう分けるか 一緒に 整理しませんか 初回30分の無料相談で、見積書や報告書など、社内で回している書類と、確認の手順を伺います。AIに任せる部分、人が確かめる部分、社内のルールの文書化を、社内で使える形にまとめます。
メールは2営業日以内に返信します。送信だけで契約や相談日時は確定しません。
この記事の確かめ方 2026年10月7日の15時台から19時台に、ChatGPT(Pro、Chatモード、思考「Medium」)、Claude(Max、Opus 5.5、思考「中」)、Gemini(無料、Flash)で、同じ2つのPDF(見積書と社内ルール)を添付し、新しいチャットで依頼しました。依頼は、上司役の文を3回、普通の文を1回、3つのAIそれぞれに出し、全12回です。回数は始める前に決め、結果を見てから増やしていません。見積書は、当社の見積書と同じ形の模擬書類で、宛先は架空です。仕込んだ間違い10個の正解は、始める前に表にしました。回答は、書類の場所と間違いの中身を具体的に書いたものを「見つけた」と数え、事実に反する指摘と、「合っている」と誤って書いた箇所は別に数えています。「値引きが合計に入っていない」は、原因まで書いた回だけを数えました。曜日は、2026年10月31日が土曜日であることをカレンダーで確かめています。日本経済新聞の見出しは、はてなブックマークの一覧で確認し、本文は有料のため読んでいません。「AI上司」がXの急上昇に入ったことは、トレンド集計サイトの2026年10月7日11時台の表示で確認しました。ChatGPTのプランは、請求画面の「ChatGPT Pro 200」の表示で確かめています。Geminiの無料版の変更は、Googleの公式ヘルプのうち、モデル・プラン別アクセス変更の説明ページを、2026年10月7日に読んで確認しました。ページはその後、書き換わっています。全12回の回答の記録(11回は要点の抜粋、1回は全文)と採点を、確かめ記録として保存しています。